Entenda por que um artigo não é indexado no Google e confira um guia passo a passo para diagnosticar e resolver problemas de visibilidade orgânica.
Escrito e publicado pelo BlogPost Automático
Um artigo não aparece no Google quando o mecanismo de busca não conseguiu descobrir a URL, foi bloqueado durante o rastreamento ou avaliou a página como insuficiente para a indexação Google. Para corrigir o problema de um artigo não indexado, é necessário identificar em qual etapa do fluxo de busca a página ficou retida.
A diferença entre descoberta, rastreamento, indexação e ranqueamento
A causa exata de um artigo não ser exibido na busca depende diretamente da fase em que o robô do Google encontrou um obstáculo. Confundir essas etapas faz com que gestores apliquem correções erradas, como reescrever um texto impecável que o robô sequer chegou a visitar.
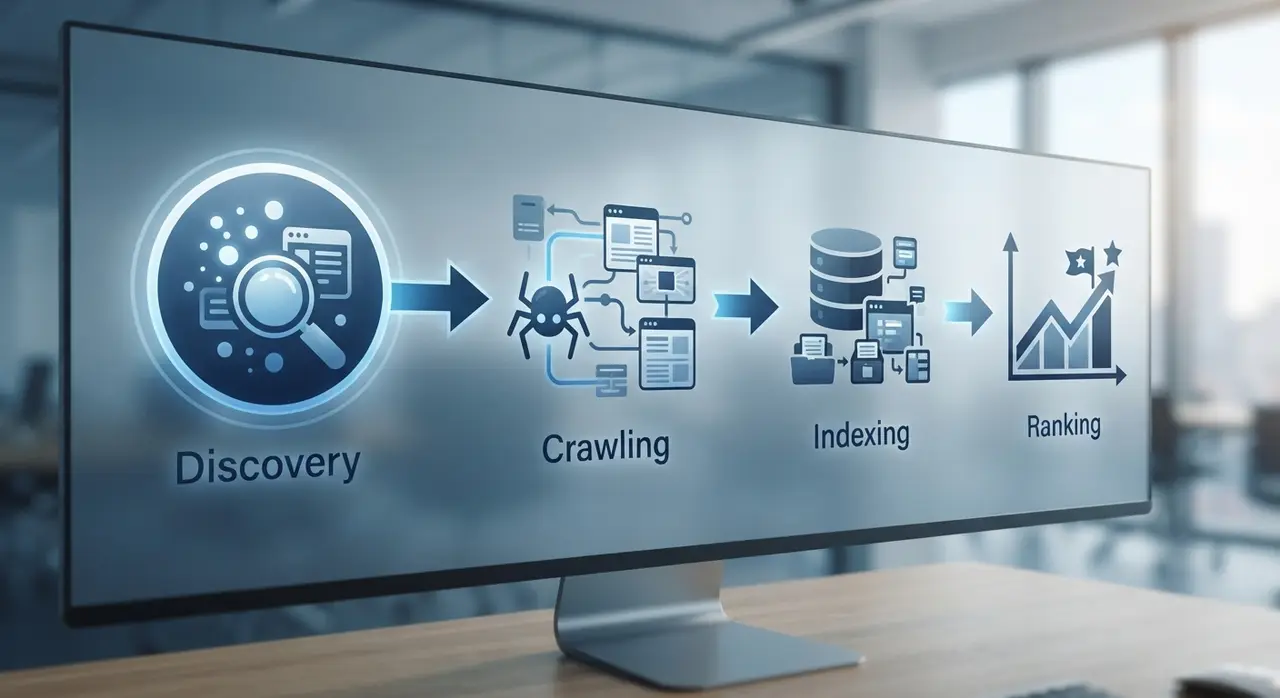
O processo de busca ocorre em quatro passos sequenciais:
- Descoberta: O Google descobre que a URL existe por meio de sitemaps XML ou links de outros sites.
- Rastreamento (Crawl): O robô (Googlebot) baixa o código HTML, imagens e assets da página para ler seu conteúdo.
- Indexação: O Google analisa a qualidade, originalidade e relevância do conteúdo e decide se deve armazená-lo em seu banco de dados oficial.
- Ranqueamento (Ranking): O algoritmo posiciona a página indexada nas respostas para pesquisas específicas dos usuários.
Se o seu artigo não aparece na busca, o problema está em um desses quatro pontos. Entender essa distinção economiza horas de refação técnica e editorial.
Diagnóstico técnico: status HTTP, robôs e tags canônicas
Falhas de configuração técnica em robôs ou tags de cabeçalho podem proibir explicitamente o Google de armazenar uma página. Antes de questionar a qualidade do texto, é indispensável auditá-la no nível da infraestrutura da web.
Os três pontos primários de bloqueio técnico são:
- Código de status HTTP incorreto: Se o servidor retornar códigos como 404 (não encontrado), 403 (proibido) ou 500 (erro interno), o robô interromperá o processamento da URL.
- Diretiva noindex ou bloqueio via robots.txt: Uma tag
<meta name="robots" content="noindex">no cabeçalho avisa o Google para desconsiderar a página. Da mesma forma, uma regraDisallowno arquivorobots.txtprevine que o robô rastreie o endereço. - Tag Canonical apontando para outro endereço: Se a marcação
rel="canonical"indicar outra URL como a versão principal, o Google transferirá a autoridade e não indexará o artigo atual.
A tabela a seguir resume como esses fatores técnicos afetam a presença da página:
| Estágio da falha | Sintoma no Search Console | Causa provável | Ação recomendada |
|---|---|---|---|
| Rastreamento | Bloqueada pelo arquivo robots.txt | Regra Disallow genérica ou incorreta | Ajustar as permissões no robots.txt da aplicação |
| Indexação | Excluída por tag 'noindex' | Plugin de SEO ou CMS configurado com bloqueio | Remover a meta tag noindex da página afetada |
| Processamento | Página alternativa com tag canônica adequada | URL aponta canonical para outra página do site | Revisar e corrigir a tag rel="canonical" no cabeçalho |
| Disponibilidade | Erro de servidor (5xx) | Instabilidade na hospedagem ou falha de código | Estabilizar o servidor e verificar os logs do sistema |
A importância da arquitetura de links internos e sitemap XML
Uma estrutura de links internos deficiente reduz a capacidade do robô de encontrar e priorizar páginas em um site. Páginas orfãs — aquelas que não recebem nenhum link de outras páginas internas — raramente recebem atenção do Googlebot.
Manter um sitemap XML atualizado no Google Search Console garante que novos artigos entrem na fila de descoberta imediatamente após a publicação. Contudo, o sitemap é apenas uma sugestão: o motor de busca prioriza páginas respaldadas por uma boa arquitetura de links internos. Garantir que cada novo artigo receba menções contextuais de páginas já estabelecidas sinaliza a relevância temática daquele conteúdo.
Qualidade e utilidade do conteúdo na decisão de indexação
O Google descarta páginas que não atingem um nível mínimo de originalidade e valor prático para o usuário. Mesmo que a página esteja tecnicamente perfeita, o algoritmo pode optar por não indexá-la se avaliar o conteúdo como raso, redundante ou gerado sem diferenciação comercial.
Com as atualizações focadas em sistemas de conteúdo útil (Helpful Content), acervos de blogs que publicam artigos commodities enfrentam o status de "Rastreada - hoje não indexada". Para evitar essa rejeição editorial, o conteúdo deve responder diretamente à intenção de busca, apresentar dados concretos e demonstrar autoridade no assunto. Ao analisar as causas de um artigo não indexado, a falta de profundidade e a ausência de Information Gain são frequentemente as razões ocultas.
Estudo de caso: normalização de indexação em um acervo editorial B2B
Empresas com acervos extensos frequentemente enfrentam estagnação no tráfego quando dezenas de páginas publicadas permanecem fora do índice. Uma empresa do setor de serviços B2B notou que 35% do seu blog mantinha o status de "Descoberta - não indexada no momento".
Ao realizar o diagnóstico, a equipe identificou dois problemas centrais: falta de apontamentos internos e textos rasos gerados sem direcionamento contextual. Ao adotar a plataforma da BlogPost Automático para reestruturar os clusters de tópicos e otimizar os artigos com informações específicas da empresa, a taxa de indexação subiu para 98% em seis semanas, resultando em um crescimento orgânico substancial sem necessidade de refalação manual diária.
Como usar o Google Search Console para identificar a causa exata
O relatório de Indexação de Páginas do Google Search Console é a ferramenta definitiva para apontar a razão técnica exata da ausência de uma URL. Ao colar o link completo na ferramenta de Inspeção de URL, o sistema mostra o diagnóstico exato em tempo real.
Os dois alertas mais frequentes no relatório exigem ações distintas:
- Descoberta - não indexada no momento: O Google sabe que a página existe, mas ainda não teve orçamento de rastreamento (crawl budget) ou interesse prioritário para visitá-la. Solução: melhore os links internos apontando para ela e envie o link via sitemap.
- Rastreada - hoje não indexada: O Google visitou e leu a página, mas decidiu não armazená-la no índice. Solução: reescreva o conteúdo adicionando valor exclusivo, corrija a estrutura do texto e garanta alinhamento com a intenção do leitor.
Perguntas frequentes
Quanto tempo o Google demora para indexar um artigo novo?
O tempo de indexação varia de poucas horas a algumas semanas, dependendo da autoridade do domínio e da frequência de publicação do site. Sites estabelecidos com sitemap ativo costumam ter novas páginas indexadas em até 48 horas.
Por que o Search Console mostra 'Rastreada - hoje não indexada'?
Esse status significa que o Googlebot visitou a página, lendo seu conteúdo, mas concluiu que ela não agrega valor suficiente para ser incluída no índice. Isso costuma acontecer devido a conteúdo superficial, textos duplicados ou falta de relevância temática dentro do site.
O uso de IA na produção de conteúdo impede a indexação no Google?
Não, o Google avalia a qualidade, precisão e utilidade do conteúdo, independentemente de como ele foi produzido. O risco ocorre quando se publica conteúdo automatizado genérico e sem revisão, o que aciona filtros contra abuso de conteúdo em escala.